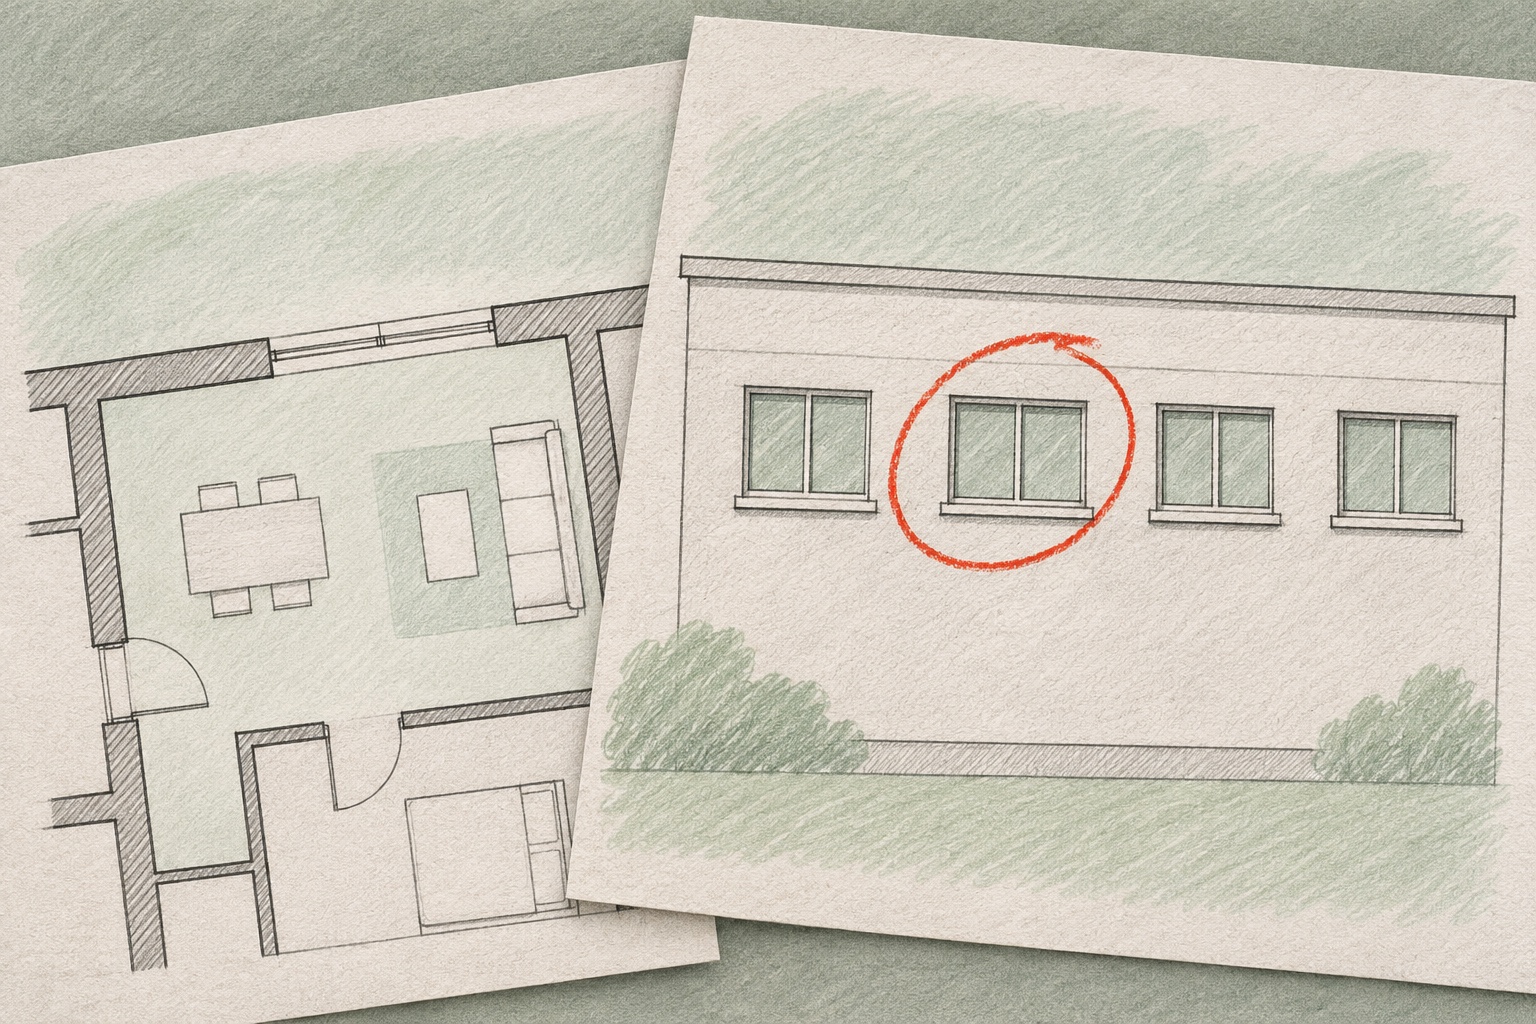
Ein Fenster kann im Grundriss richtig aussehen und in der Fassadenansicht trotzdem mit der falschen Breite eingezeichnet sein. In einer Beispielaufgabe eines neuen KI-Benchmarks soll ein Agent fünf Grundrisse mit Schnitten und Fassadenansichten abgleichen, Abweichungen und ungeklärte Fälle kennzeichnen und seine Befunde mit Ausschnitten aus den Zeichnungen belegen. Das Ergebnis ist eine Präsentation, die ein Architekt prüfen kann.
Google DeepMind und Artificial Analysis stellten den Benchmark Multimodal Knowledge Agent am 10. November vor. Der bewertete Datensatz umfasst 200 nicht öffentliche Aufgaben aus zehn Branchen. Artificial Analysis lässt die Agenten in derselben Softwareumgebung mit bis zu 250 Schritten pro Aufgabe arbeiten. Eine KI bewertet die eingereichten Ergebnisse anhand von Kriterien, die Fachleute formuliert haben. Die Prüfung der Zeichnungen gehört zu den separaten öffentlichen Beispielen, die sich Teams ansehen können.
Die zentrale Kennzahl gibt an, welchen Anteil der gewichteten Punkte für schwierigere Kriterien die Modelle im Schnitt pro Aufgabe erreichen. Im technischen Bericht von Google DeepMind kommt Claude Fable 5.2 auf 56,56 Prozent und Gemini 4 Carbon auf 54,34 Prozent. Die Differenz von 2,22 Prozentpunkten lag innerhalb der statistischen Unsicherheit der Studie. Die Prozentwerte geben die im Test erreichten Punkte wieder. Wie oft ein Agent ein falsch bemessenes Fenster übersieht, lässt sich daraus für die Projektleitung nicht ableiten.
Der Bericht beziffert die durchschnittlichen API-Kosten zu Listenpreisen auf 35,28 US-Dollar pro Aufgabe für Fable und 5,63 US-Dollar für Carbon. Das entspricht in diesen Testläufen einem Verhältnis von rund 6,3 zu 1. In den eigenen Ergebnissen zur Einführung des Benchmarks nennt Artificial Analysis andere Durchschnittswerte: 31,97 und 6,29 US-Dollar, also rund 5,1 zu 1. Für ein Team, das einen Probelauf kalkuliert, bleibt in beiden Fällen offen, wie viel Zeit die Mitarbeitenden brauchen, um die Befunde zu prüfen und übersehene Abweichungen zu entdecken.
Ein Büro könnte die Modelle an einem Zeichnungssatz erproben, den seine Mitarbeitenden bereits geprüft haben. Es könnte übersehene Abweichungen und Fehlalarme getrennt zählen, die Zeit für die Überprüfung jedes Hinweises anhand der Zeichnungen messen und den dafür nötigen Aufwand zu den Kosten des Testlaufs addieren. Aus dem öffentlichen Beispiel lässt sich ein Verfahren übernehmen. Der Agent darf angeben, dass sich eine Frage anhand der Zeichnungen nicht klären lässt, und soll dann die Belege vorlegen, die ein Mensch für seine Entscheidung braucht.