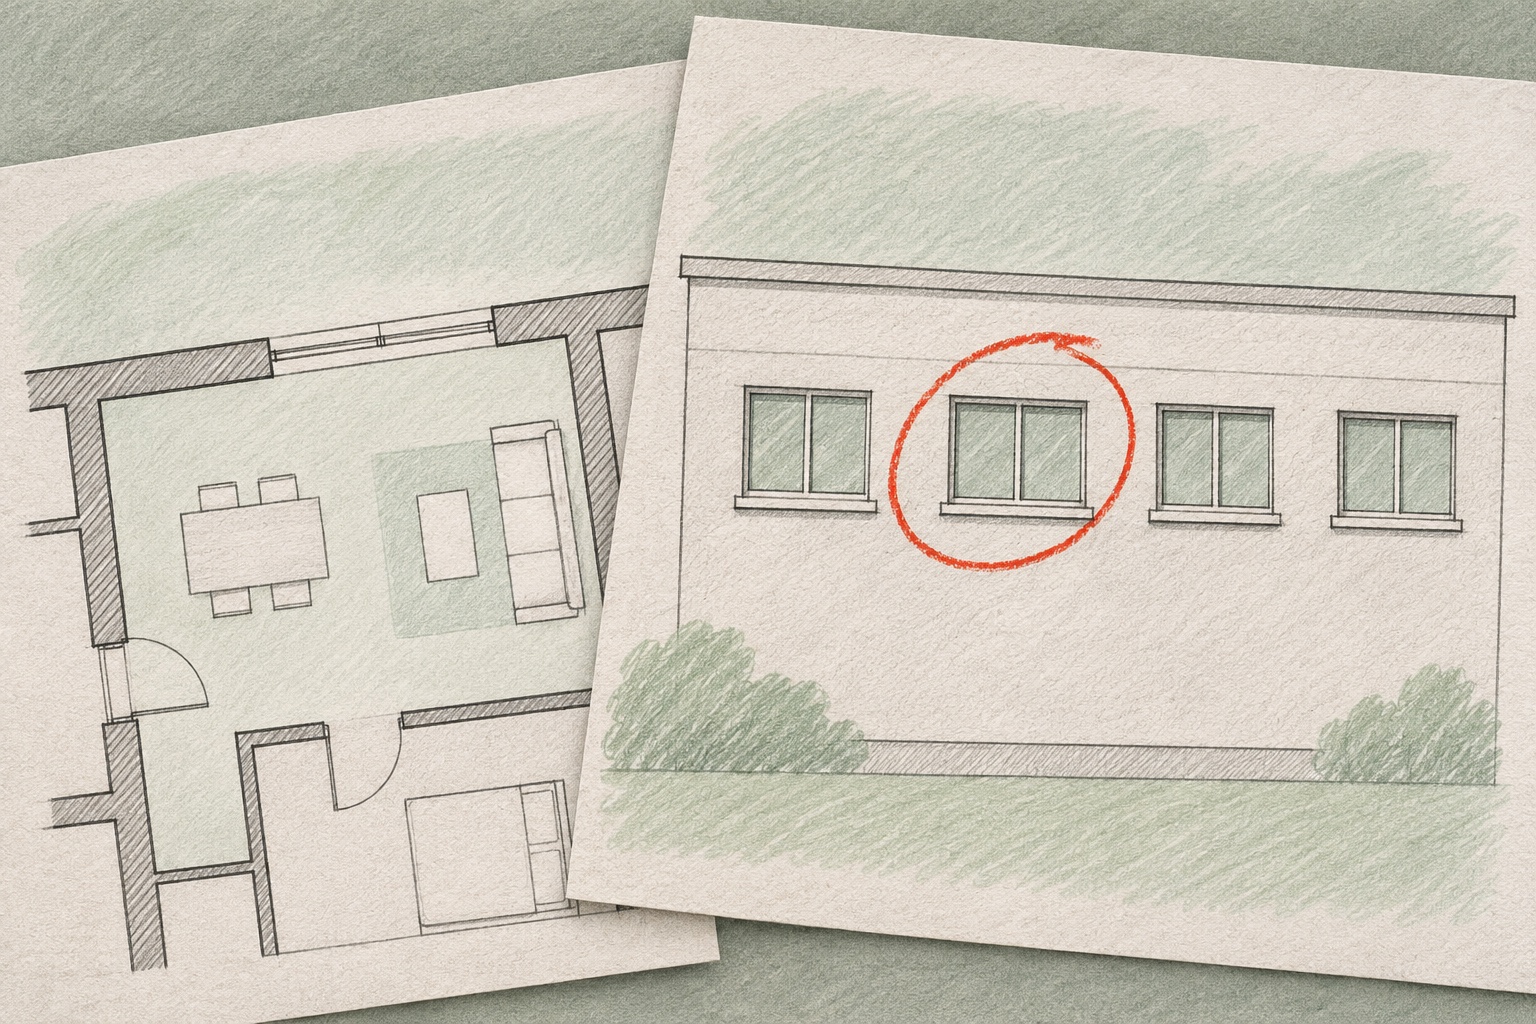
Una ventana puede parecer correcta en el plano de planta y aun así aparecer con un ancho equivocado en el alzado. En un ejercicio de muestra de una nueva prueba de IA, un agente debe cotejar cinco planos de planta con secciones y alzados, señalar discrepancias y casos que no puede resolver y respaldar sus hallazgos con recortes de los dibujos. El resultado es una presentación que un arquitecto puede revisar.
Google DeepMind y Artificial Analysis presentaron la prueba Multimodal Knowledge Agent el 10 de noviembre. El conjunto que se puntúa incluye 200 tareas privadas de diez sectores. Artificial Analysis ejecuta los agentes en el mismo entorno de software, con un máximo de 250 turnos por tarea. Un sistema de IA evalúa los trabajos entregados con criterios redactados por especialistas. La revisión de planos forma parte de un conjunto separado de ejemplos públicos que los equipos pueden consultar.
La puntuación principal promedia, tarea por tarea, la proporción de puntos ponderados que se obtienen en los criterios más exigentes. En el informe técnico de Google DeepMind, Claude Fable 5.2 obtuvo un 56,56 % y Gemini 4 Carbon, un 54,34 %. La diferencia de 2,22 puntos porcentuales quedó dentro del margen de incertidumbre estadística del estudio. Esos porcentajes indican los puntos obtenidos en la prueba. Un jefe de proyecto no puede deducir de ellos con qué frecuencia un agente pasará por alto una ventana de ancho incorrecto.
El informe situó el costo medio de la API a precios de lista en 35,28 dólares estadounidenses por tarea para Fable y 5,63 para Carbon, una relación de alrededor de 6,3 a 1 en esas pruebas. En sus propios resultados del lanzamiento, Artificial Analysis publicó otros promedios: 31,97 y 6,29 dólares, alrededor de 5,1 a 1. En ambos casos, a un equipo que calcula el presupuesto de una prueba piloto le queda una pregunta por resolver. ¿Cuánto tiempo dedicará el personal a comprobar los hallazgos y detectar omisiones?
Un estudio de arquitectura podría probar los modelos con un juego de planos que su personal ya haya revisado. Podría contar por separado las discrepancias omitidas y las falsas alarmas, medir cuánto tarda un revisor en localizar en los planos el respaldo de cada aviso y sumar el costo de ese tiempo al de la prueba. El ejemplo público ofrece un procedimiento que vale la pena adoptar. Permitir que el agente indique cuándo los planos dejan una cuestión sin resolver y pedirle después las pruebas que una persona necesitaría para decidir.