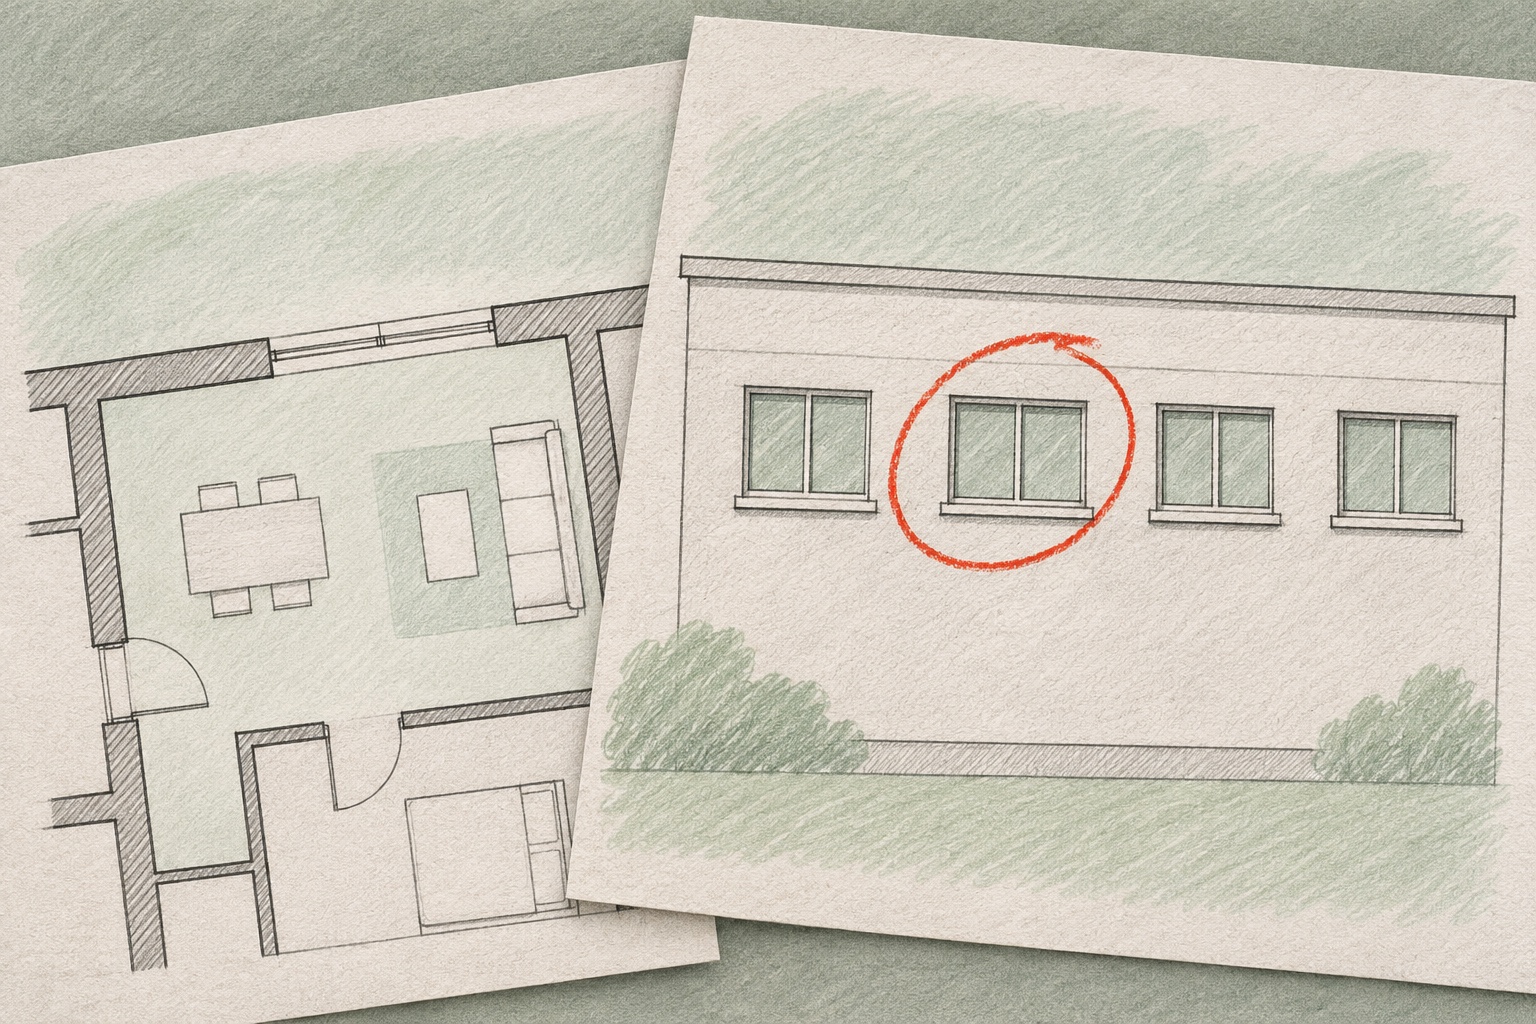
Une fenêtre peut sembler correcte sur un plan d’étage et pourtant apparaître avec une largeur erronée sur une élévation. Dans un exemple de tâche d’un nouveau test d’IA, un agent doit comparer cinq plans d’étage avec des coupes et des élévations, signaler les incohérences et les cas qu’il ne peut trancher, puis étayer ses constats avec des extraits des dessins. Le résultat est un diaporama qu’un architecte peut examiner.
Google DeepMind et Artificial Analysis ont présenté le test Multimodal Knowledge Agent le 10 novembre. Le jeu de données utilisé pour établir les scores compte 200 tâches non publiques dans dix secteurs. Artificial Analysis fait travailler les agents dans le même environnement logiciel, avec un maximum de 250 tours par tâche. Un système d’IA évalue les travaux remis selon des critères rédigés par des spécialistes. La vérification des plans figure dans une série distincte d’exemples publics que les équipes peuvent consulter.
Le score principal correspond à la moyenne, sur l’ensemble des tâches, de la part des points pondérés obtenus sur les critères les plus difficiles. Dans le rapport technique de Google DeepMind, Claude Fable 5.2 obtient 56,56 % sur cet indicateur et Gemini 4 Carbon, 54,34 %. L’écart de 2,22 points de pourcentage se situe dans la marge d’incertitude statistique de l’étude. Ces pourcentages indiquent les points obtenus au test. Ils ne permettent pas à un chef de projet de savoir à quelle fréquence un agent passera à côté d’une erreur de largeur de fenêtre.
Le rapport chiffre le coût moyen de l’API au tarif catalogue à 35,28 dollars américains par tâche pour Fable et à 5,63 dollars pour Carbon, soit un rapport d’environ 6,3 à 1 dans ces essais. Dans ses propres résultats de lancement, Artificial Analysis donne d’autres moyennes, 31,97 et 6,29 dollars, soit environ 5,1 à 1. Pour une équipe qui établit le budget d’un essai, la question reste la même. Combien de temps le personnel consacrera-t-il à vérifier les constats et à repérer les omissions ?
Un cabinet pourrait tester les modèles sur un jeu de dessins déjà contrôlé par son personnel. Il pourrait compter séparément les écarts non détectés et les fausses alertes, mesurer le temps nécessaire pour vérifier chaque signalement à partir des plans et ajouter le coût de ce temps à celui de l’essai. L’exemple public propose une démarche à reprendre. Laisser l’agent signaler que les dessins ne permettent pas de trancher, puis lui demander les éléments dont une personne aurait besoin pour décider.